起因很简单:笔记写了三年,多到自己都不想翻。
一、痛点:笔记越多,越像垃圾场
我攒了一堆 Markdown 笔记 —— Typora 写的、从自己 Hugo 博客导出的、还有各处抄下来存档的。文件名五花八门,图片散在五个不同的图床,同一件事在两篇笔记里说法还不一样。
量不算大,但"能直接用"的没几份:
- 找不到 —— 想查某个知识点,不知道该翻哪一篇
- 不放心 —— 笔记是几年前写的,里面的 API 可能早就废弃了
- 不成体系 —— 知识点是散的,面试要用的时候串不起来
我试过纯手动整理,结论是:整理笔记这件事会持续消耗意志力,而意志力是会用完的。
二、为什么是 Obsidian + WorkBuddy
分工原则一句话:
素材只读,wiki 由 AI 写,我只负责"给素材"和"提问"。
- Obsidian 负责"装":纯本地 Markdown 文件夹、
[[双链]]、关系图谱、全文搜索。数据在自己硬盘上,不怕平台跑路。 - WorkBuddy 负责"干":能读写本地文件、跑脚本、抓网页、读 PDF,关键是 —— 你说人话,它干活。
两者之间靠一个 skill 粘起来,这也是整篇文章的主角。
三、核心:一个叫 Karpathy LLM Wiki 的 skill
整套玩法的发动机,是 WorkBuddy 里的一个 skill —— Karpathy LLM Wiki。
它来自 Andrej Karpathy 提出的「LLM Wiki」思路:不要 RAG,要"增量编译"。
传统做法(RAG)是你每问一次,就去素材库里检索一遍;而它反着来 —— 你每丢进来一份素材,它就读一遍、提炼要点,然后写进 wiki,顺手更新相关页面、标注和新结论矛盾的地方,把零散的信息缝合成一张网。
所以这个 wiki 是一个会复利的产物:交叉引用早就连好了,矛盾被标出来了,综述反映的是你读过的全部内容。素材越多、问得越多,它就越厚、越准。
它把内容分成三层,边界很清楚:
| 层 | 谁维护 | 说明 |
|---|---|---|
| 素材 raw/ | 你 | 只许放,不许改 —— 唯一的事实来源 |
| wiki/ | AI | 摘要、概念页、综述、对比…… 你只读不写 |
| WIKI-SCHEMA.md | 你和 AI 共同演进 | 约定目录、分类、页面格式 |
一句话概括分工:你负责喂素材、提问题;AI 负责写页面、查矛盾。
四、日常只有三个指令
整套工作流,你只需要记住三个动词:
| 指令 | 你说的话 | 它做的事 |
|---|---|---|
| 入库 Ingest | “把这篇素材入库” | 读素材 → 写摘要页 → 更新目录 → 顺带更新相关页面 → 记一条日志 |
| 提问 Query | “XX 这个知识,我库里是怎么说的?” | 先读目录定位,再综合出答案并给出引用;好答案会落盘成新页面 |
| 体检 Lint | “给知识库做一次体检” | 找矛盾、过时断言、孤儿页、缺失的双链和内容缺口 |
就这三句。剩下的它自己会做。
五、它长什么样、能干嘛
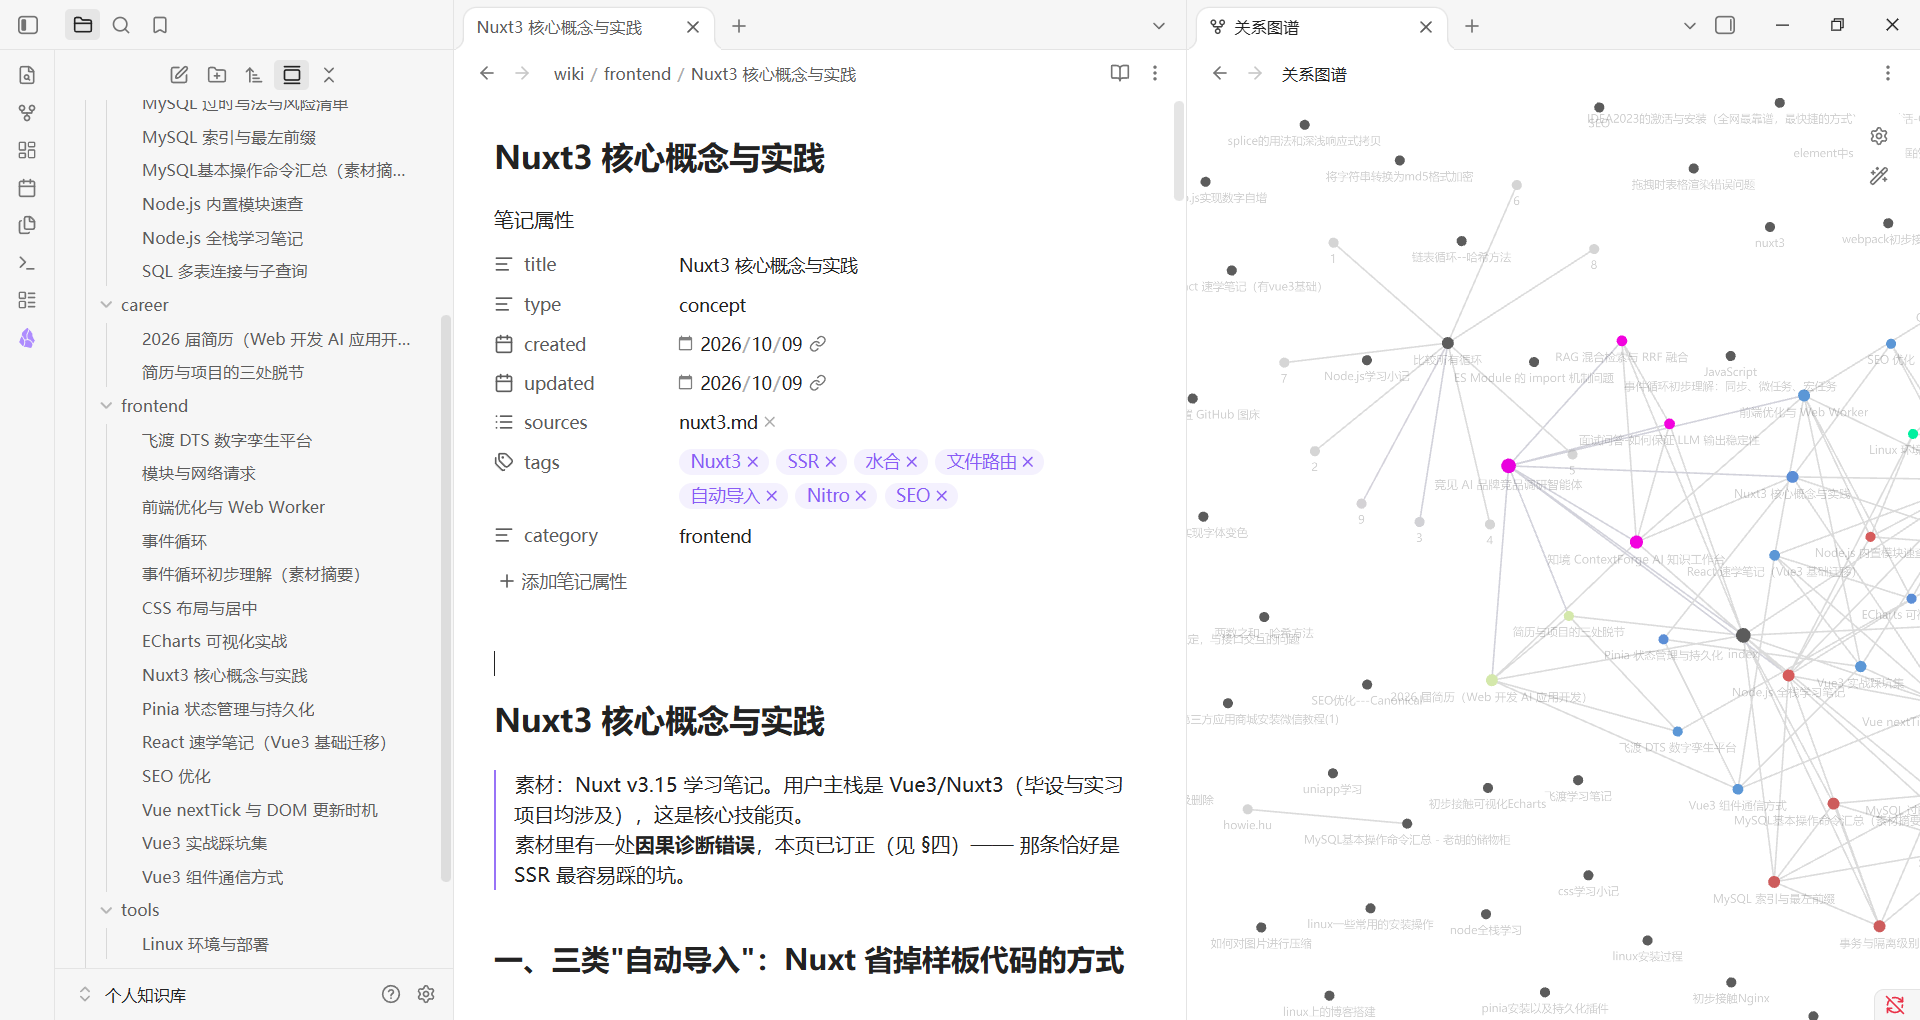
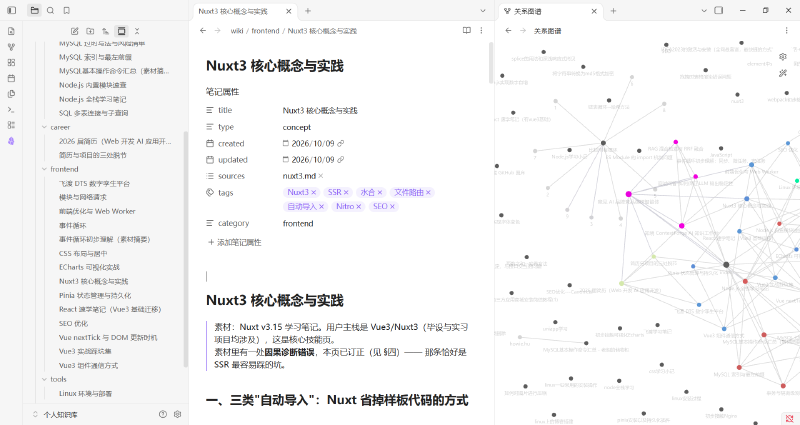
上图就是它跑起来的样子 —— 左边是文件树,中间是笔记的属性(frontmatter 可视化),右边是关系图谱。具体价值有这么几个:
- 知识沉淀:每读一份素材,wiki 就更厚一点。它是资产而不是消耗品 —— 你今天读的东西,半年后还能被检索、被引用、被缝合进新的结论里。
- 在 WorkBuddy 里直接检索:不用自己翻文件,直接问就行(“我之前整理过的那几个坑是哪些?"),它会读相关页面、给出带引用的答案;如果这个回答有价值,还能让它落盘成一个新页面,而不是沉在聊天记录里。
- 双链 + 图谱:页面之间用
[[双链]]连起来,Obsidian 的图谱会把这些连接画成一张网 —— 你能一眼看出哪些知识点是孤立的、哪些是核心枢纽。 - 体检兜底:内容一多就容易自己打架。定期跑一次体检,矛盾、过时、断链、缺口都会列出来。
- 随时能搬走:说到底就是一堆
.md文件,可以用 git 管版本,不绑定任何平台。
六、怎么开始
第一步:装 Obsidian
官网直接下载,Windows / macOS / Linux / 手机端都有,免费:
下载地址:https://obsidian.md/download
先装好,但先别急着建仓库 —— 下一步会告诉你仓库放哪。
第二步:让 WorkBuddy 帮你把仓库建好
在 WorkBuddy 里启用 Karpathy LLM Wiki skill(其他能装 skill、能读写本地文件的 agent 同理),然后说一句:
“帮我建一个个人知识库。”
它会自动把整套结构和约定建出来:
| |
注意:这一步你不用手动建任何文件夹、也不用自己写配置文件 —— 那都是 skill 的活。你只需要说一句话。
第三步:把仓库导进 Obsidian
打开 Obsidian,选 「打开文件夹作为仓库」,把它刚建好的那个目录选进去。完成,界面就和上面那张图一样了。
第四步:日常就三个指令
把新素材丢进 raw/,说"入库”;有问题就问;想保持整洁就说"体检"。就这三句。
第五步:进阶 —— 让它自己跑
真正把"意志力"这件事彻底解决掉的,是定时任务。在 WorkBuddy 里给这个知识库挂上两个定时任务:
- 定时摄入:比如每周一次,自动把
raw/里还没处理的素材入库 - 定时体检:比如每周一次,自动跑一遍 lint,把矛盾、孤儿页、内容缺口整理好发给你
之后就可以躺平了:素材随手丢,AI 每周自己整理、自己查错。
最后,安利一下
- 成本几乎为零:Obsidian 免费,数据全在你本地,没有订阅、没有额度。
- 不绑定平台:产物就是一堆 Markdown,哪天不想用了,打包带走。
- 越用越值钱:它是个复利资产 —— 不像聊天记录,问完就沉底了;这里的每一次沉淀都留在库里,等着被下一次引用。
- 谁都适合:笔记多但烂在手里的、天天读论文的、做竞品调研的、准备面试要串知识点的,都能直接用。
一句话总结:你负责喂养和提问,AI 负责整理和查错。
参考自:Andrej Karpathy 的 LLM Wiki(gist)、WorkBuddy「Karpathy LLM Wiki」skill、个人知识库实操记录(2026-10)