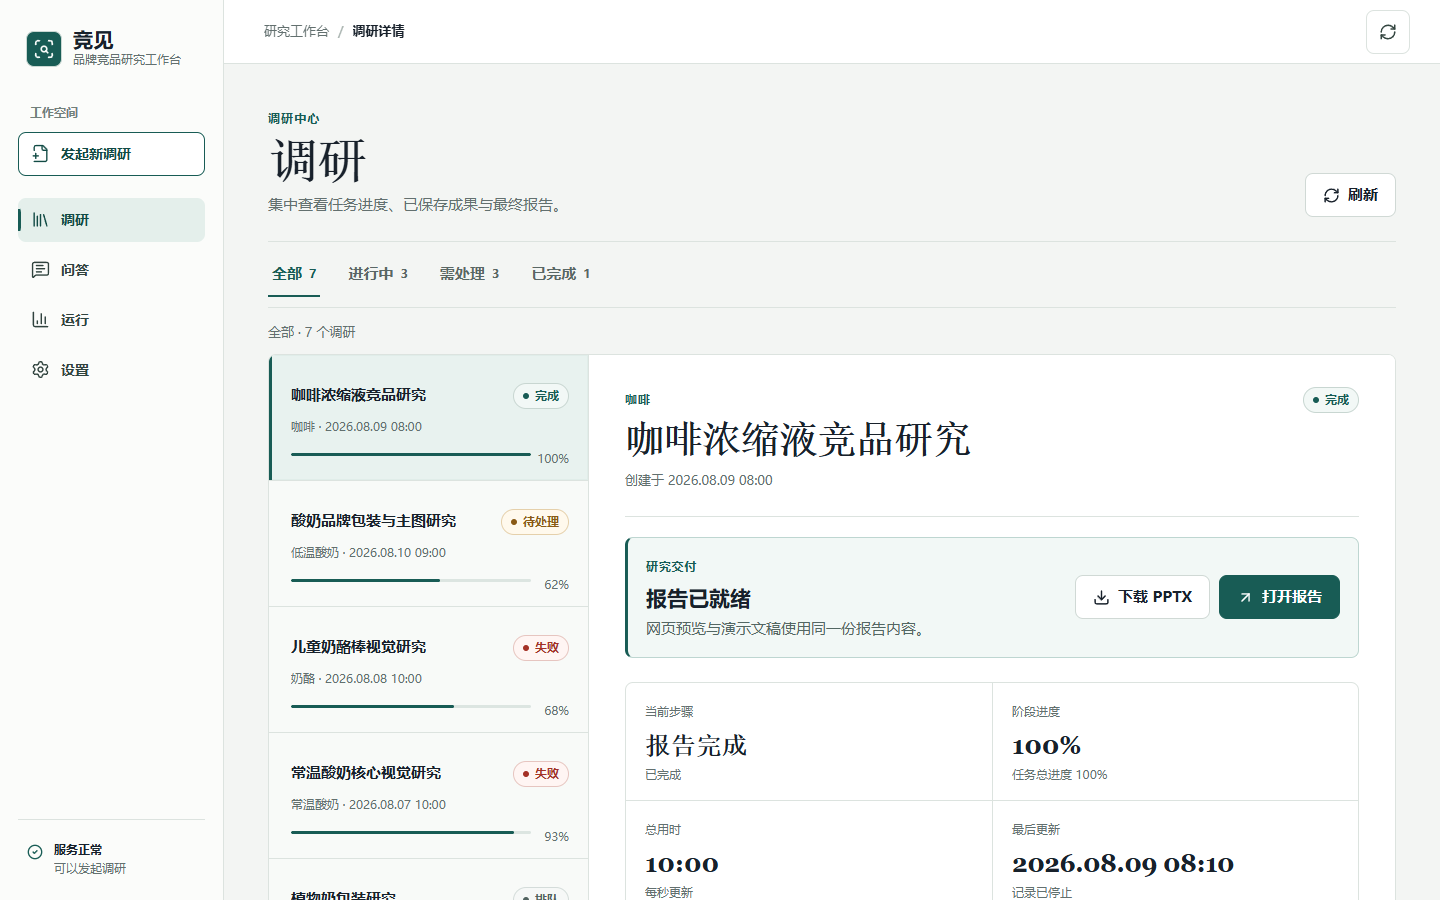
竞见是一个面向品牌和包装设计团队的淘宝竞品调研工具。输入品类、价格范围和样本量后,它会整理品牌资料,采集淘宝商品的图片、价格和规格线索,生成一份包含品牌定位、产品结构、包装视觉、价格带、竞品比较和设计建议的 PPTX。报告完成后,还能继续追问,并从回答中的引用回到原报告或原始网页核对。
本文对应 2026 年 9 月 1 日最新开发版本。界面截图使用脱敏演示数据;淘宝、搜索和模型服务需要在实际运行环境中连接。
从一份研究简报开始
用户先填写主题、品类、目标市场、价格范围和关注点,再选择快速、标准、深度或自定义样本量。提交前,页面会先检查后端服务和淘宝登录状态。同一次创建请求重试时会沿用同一个请求键,避免网络抖动造成重复任务。
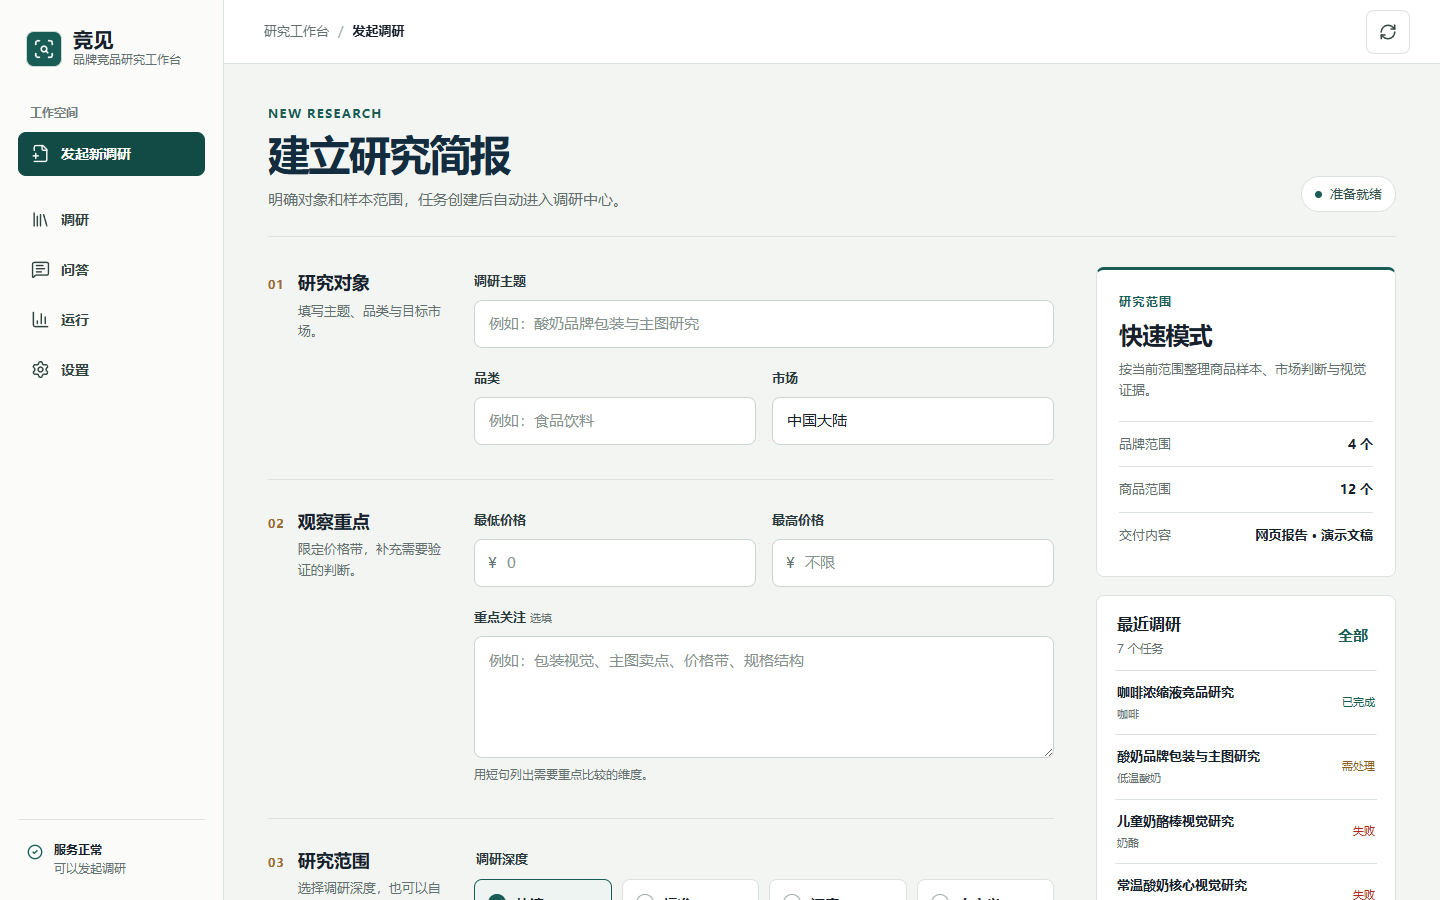
研究简报只收集会影响调研结果的条件,样本量可以按任务时间调整。
一次完整调研大致经过这条链路:
研究简报 → 品类理解 → 品牌核验 → 分品牌研究 → 淘宝商品采集 → 洞察与质检 → HTML 预览 + 一份 PPTX → 研究问答
品牌资料主要来自公开网页;商品图、价格、规格和销量线索尽量从同一张淘宝商品卡获取,避免把几个页面的信息拼成一个并不存在的商品。采集结果还会经过品类匹配、图片可用性、重复内容和版面检查。开启淘宝采集后,如果一张可用商品图都没有,任务会失败,不会拿普通网络图片填空。
淘宝登录过期或出现验证码时,任务会进入等待状态,由用户在共享 Chrome 中完成登录或验证。系统不会绕过平台验证,也不会把等待人工操作误报成程序失败。
最后得到的是什么
竞见只交付一份正式 PPTX,同时提供同内容的 HTML 预览。报告不是简单罗列搜索结果,而是按研究顺序组织:
- 开头说明研究对象、样本范围和对标结论;
- 按品牌整理定位、用户、产品线、价格层级与视觉语言;
- 保留商品样本、页面截图和来源入口;
- 最后汇总跨品牌差异、市场判断与设计建议。
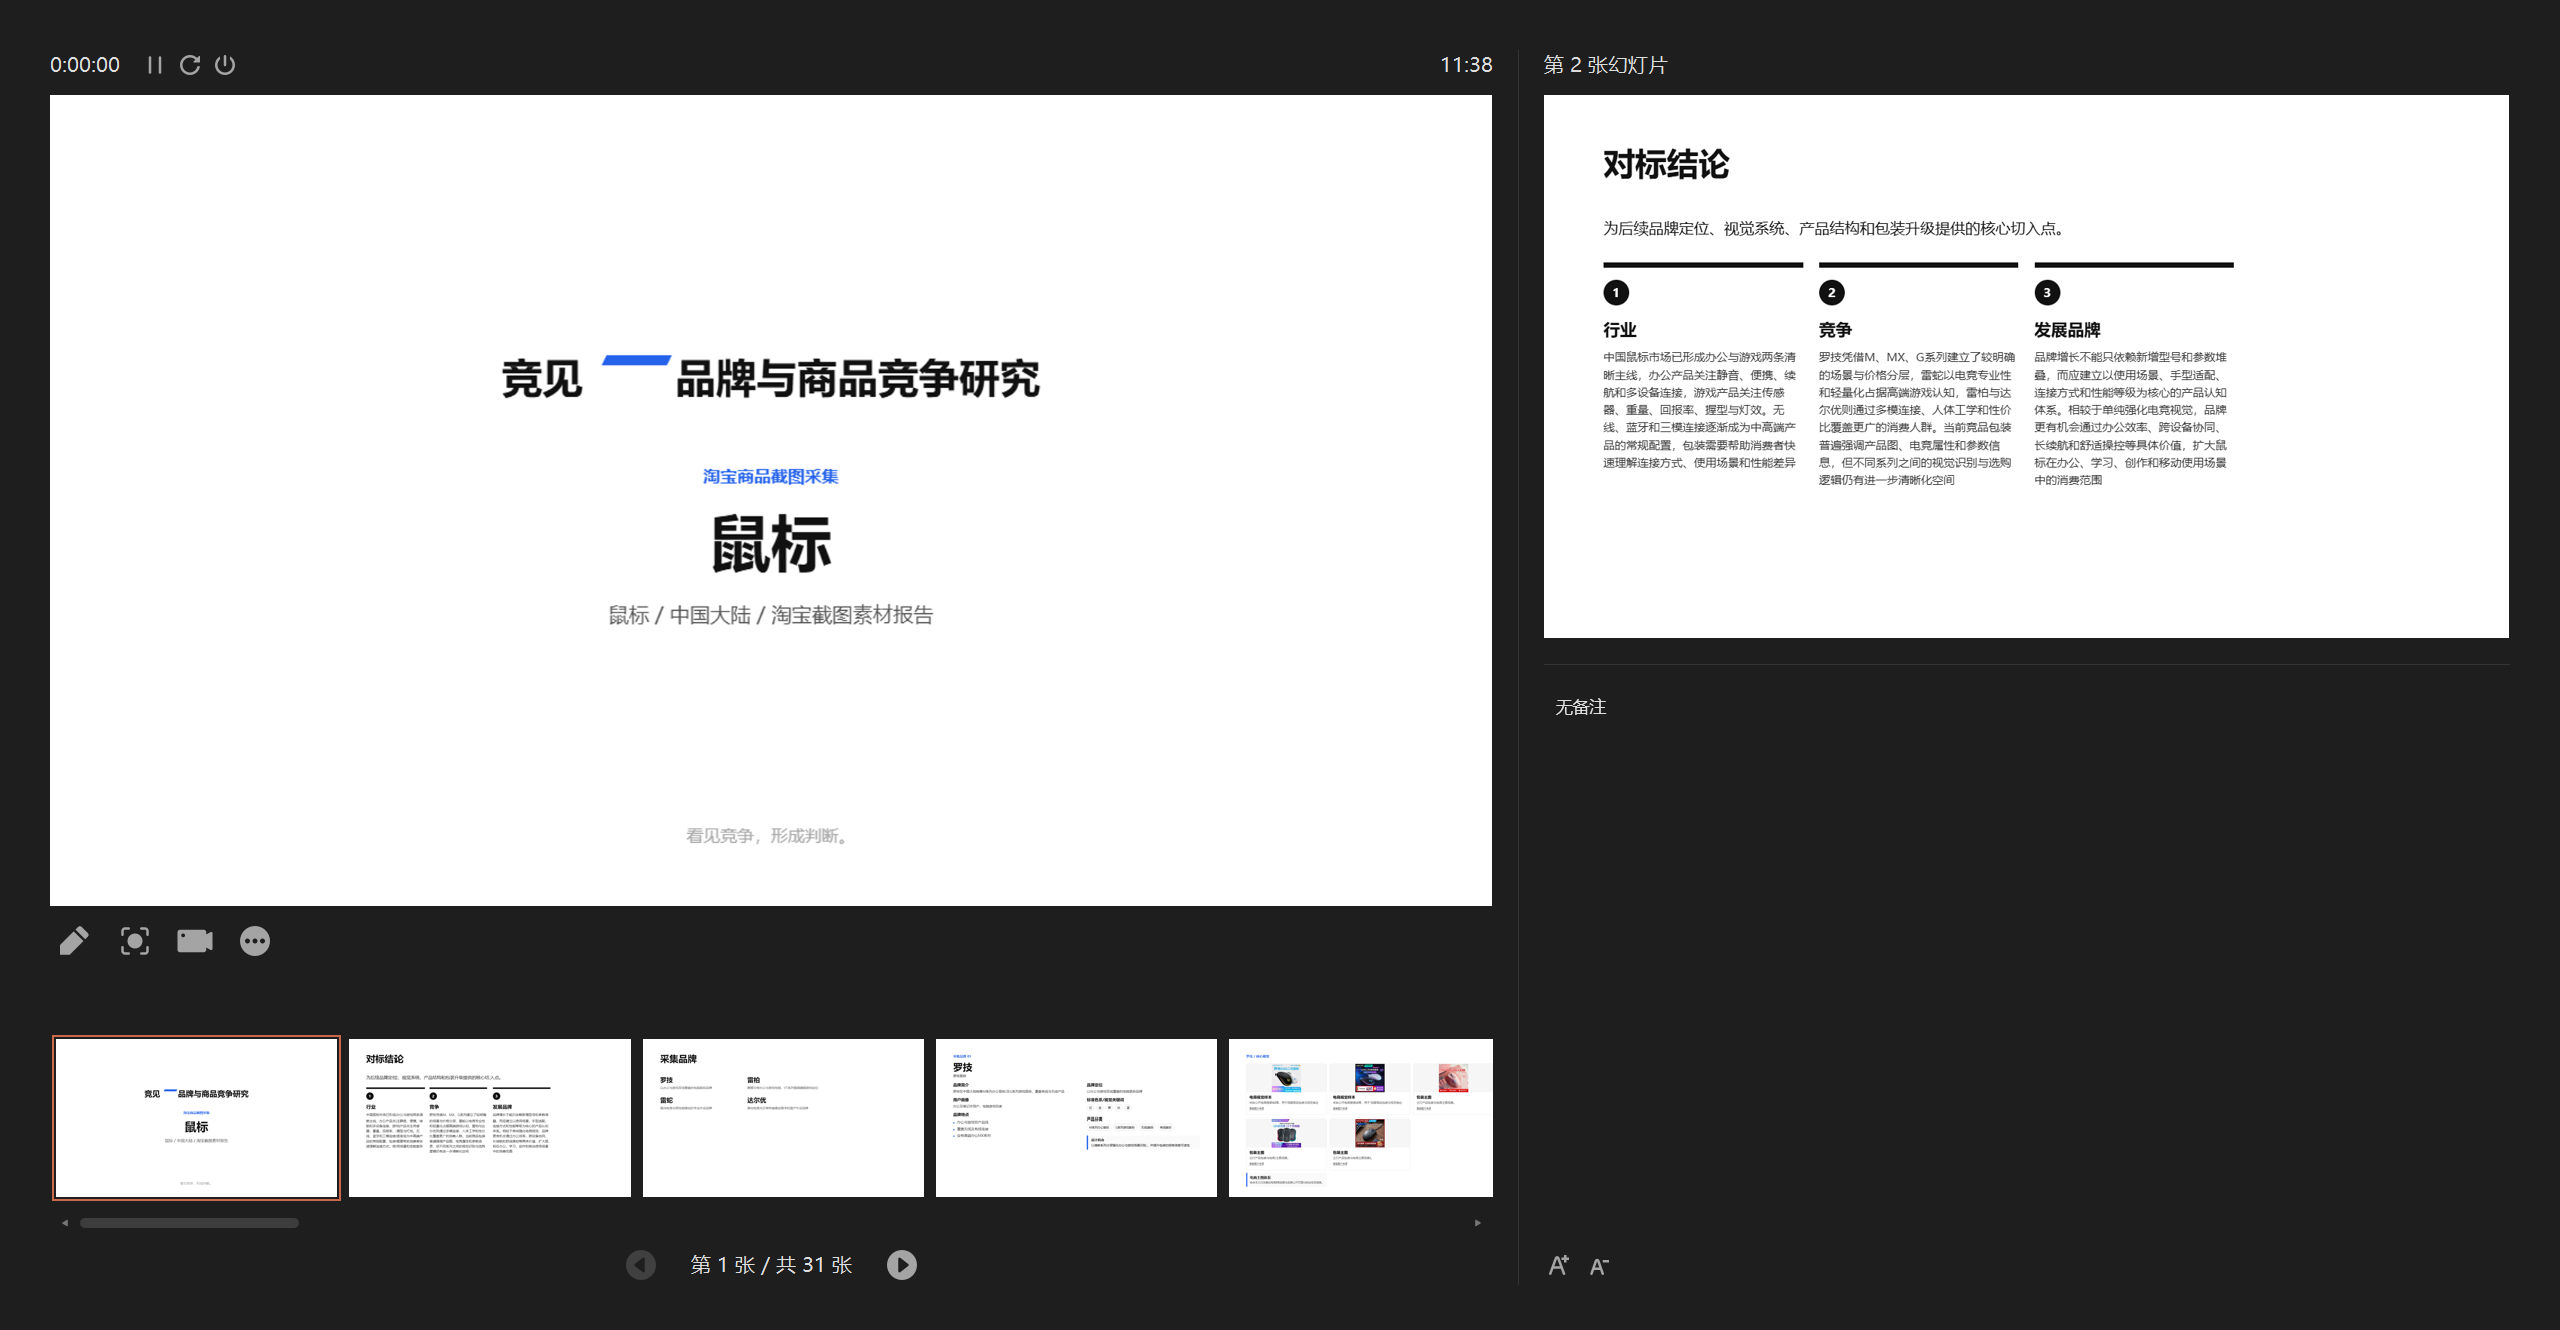
报告开头先交代研究对象,再给出行业、竞争和品牌发展层面的结论。
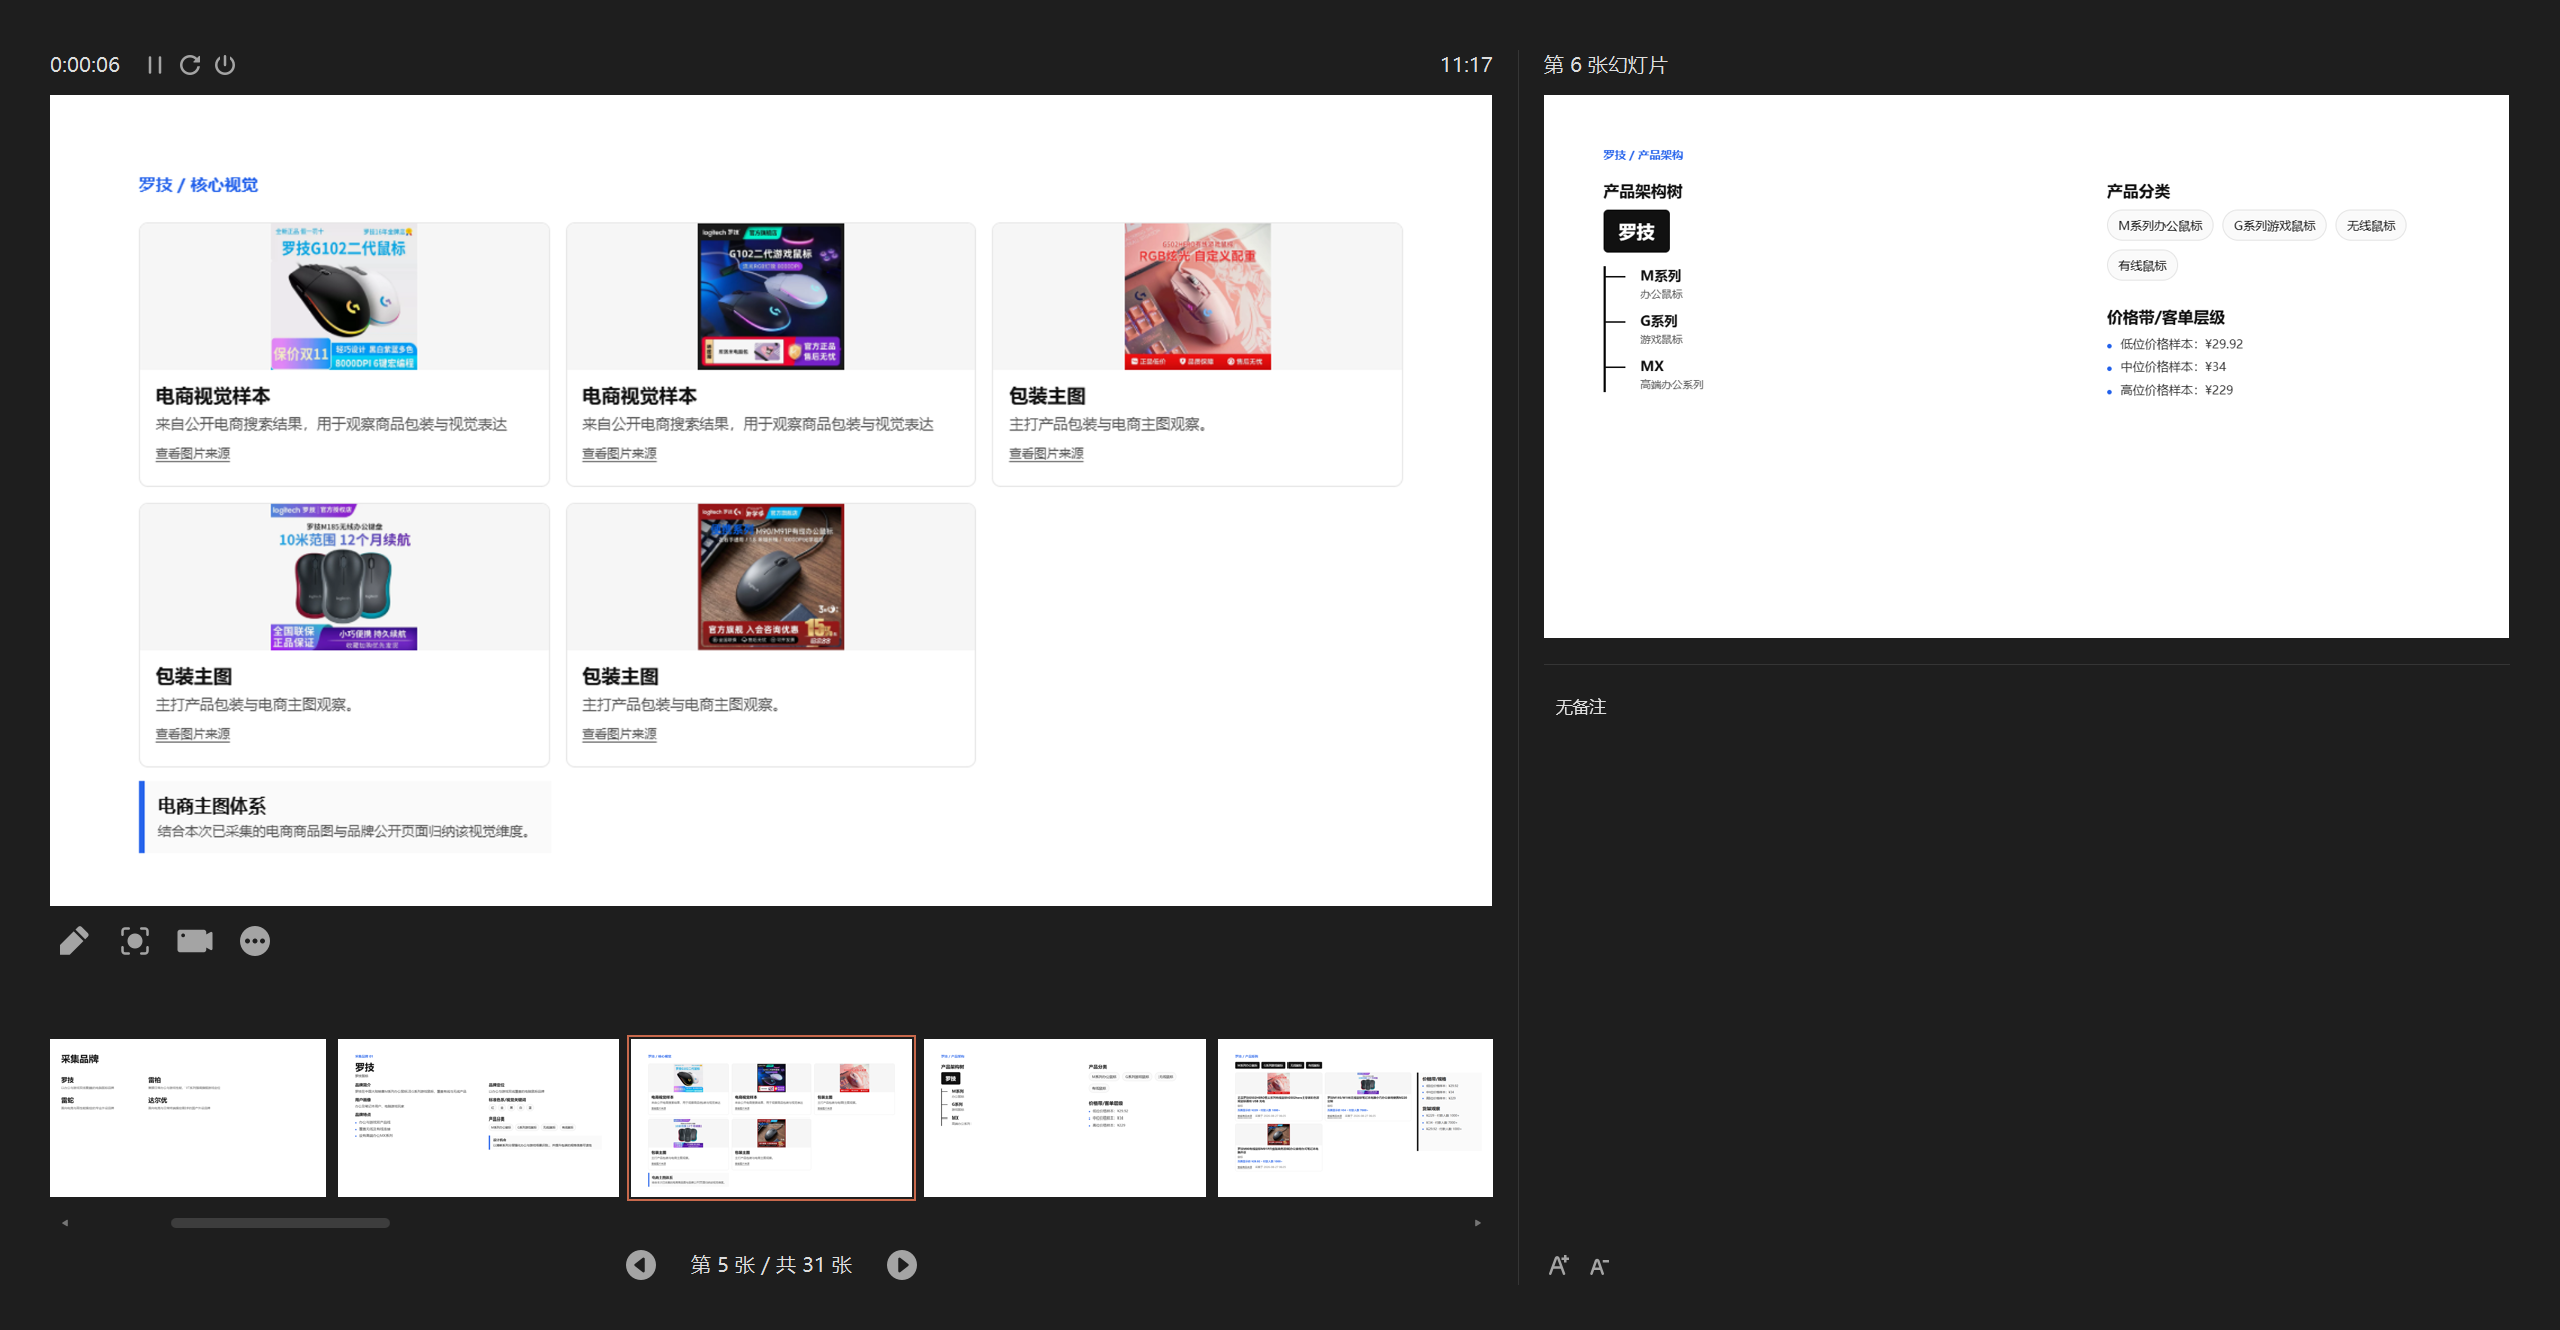
中间页保留商品样本及图片来源,再把样本整理为产品架构和价格层级。
HTML 预览和 PPTX 使用同一份报告内容,网页上看到的页序和下载文件保持一致。PPTX 的页面以整页画面为主,适合直接展示和分发,并不是由大量可逐项编辑的文本框拼成的模板;当前也不生成 PDF。
生成后,系统最多进行三轮检查和修复,处理空图、内容溢出与版面异常。能定位到具体商品图的问题会单独补采;检查未通过,就不会把报告标记为完成。
长任务为什么能停下来再继续
调研会连续调用搜索、模型、浏览器和渲染程序,不能依赖一次网页请求从头跑到尾。竞见把任务状态和最终报告保存在研究主库中,并在品类理解、品牌核验、单品牌研究、洞察整理和淘宝采集等阶段留下检查点。
浏览器页面关闭后,后台任务仍可继续。程序重启时,运行中的任务会转为“已中断、可恢复”。用户点击恢复后,检查点可用时会从兼容阶段继续;检查点不可用时仍沿用原请求,但流程会从头执行。
只有最终报告成功写入数据库,任务才会标记为完成,因此不会出现“状态已经完成,报告却没有保存”的情况。
RAG 不是把整份 PPT 塞给模型
报告问答分成两步:先把完成的报告整理成可检索证据,再让模型只根据找到的证据回答。它只查询已经完成的报告,不会在问答时重新联网采集淘宝。
报告怎样变成可检索的资料
完成的任务和报告先保存在 research.sqlite3。同步知识库时,系统从这里读取报告,再按报告结构建立检索索引。报告原文由主库统一保存,检索索引即使损坏,也可以重新生成。
竞见不会按固定字数随意截断,而是沿用报告本身的业务结构:
- 一块调研概况;
- 每个品牌一块品牌概览;
- 每个商品一块商品信息;
- 每条市场洞察和设计建议各自成块。
例如,一块品牌资料大致是这样:
| |
标题、品类、章节、metadata 和正文会组成同一份检索文本,关键词索引和向量索引都使用它。系统通过内容指纹判断报告是否真的变化,只重建变化项;外部向量全部生成并校验后,才在一次短事务里替换旧索引。中途失败时,旧索引仍能使用。
先找对报告,再从报告里找证据
一次内容提问的链路可以缩成:
问题 → 确定报告范围 → 关键词检索 + 向量检索 → 合并排序 → 取出证据 → 带引用回答
关键词检索适合查品牌名、型号和具体术语;向量检索用来寻找说法不同、意思相近的内容。两路结果通过 RRF 合并,必要时还可以让模型再排一次。精排默认关闭;没有开启或执行失败时,仍会使用原来的检索结果。
这里没有 Milvus、FAISS 或其他独立向量库。向量直接存在 SQLite 的知识块记录中,查询时由 Python 计算余弦相似度。未配置外部 Embedding 时,系统使用本地 384 维 feature-hash;它做的是文字特征匹配,不是神经语义模型。配置 Ark Embedding 后,系统才会加入语义向量。外部向量不可用或签名不一致时,查询会降级为 FTS5。
不同问题也不会强行走同一条路:
| 问题 | 处理方式 |
|---|---|
| “现在有多少份报告?” | 直接查询研究主库,不靠检索结果猜数量。 |
| “最新报告的包装策略是什么?” | 先由主库确定最新任务,再只检索这份报告。 |
| “比较最近两份报告” | 先在已同步的报告目录中限定范围,再尽量让每份报告都有证据进入候选。 |
| 没有找到可靠证据 | 直接说明证据不足,不让模型凭聊天记忆补答案。 |
多报告比较依赖已经同步的知识目录;如果索引落后,应该先同步,而不是把旧报告当成最新结果。
回答必须带回本次证据
候选知识块会标成 [S1]、[S2],来源先发给前端,回答再以流式文字显示。生成结束后,服务端检查回答是否至少引用了一条来源,以及引用编号是否真的存在于本轮候选中。检查失败,这轮回答不会被当成完成结果。
这能阻止模型编造一个不存在的 [S99],但不能代替人工判断。界面仍会保留报告入口、章节和原始网页链接,方便读者自己核对。
最新版还可以直接复制用户问题和已经结束的回答;仍在流式生成的半截回答不会显示复制按钮。
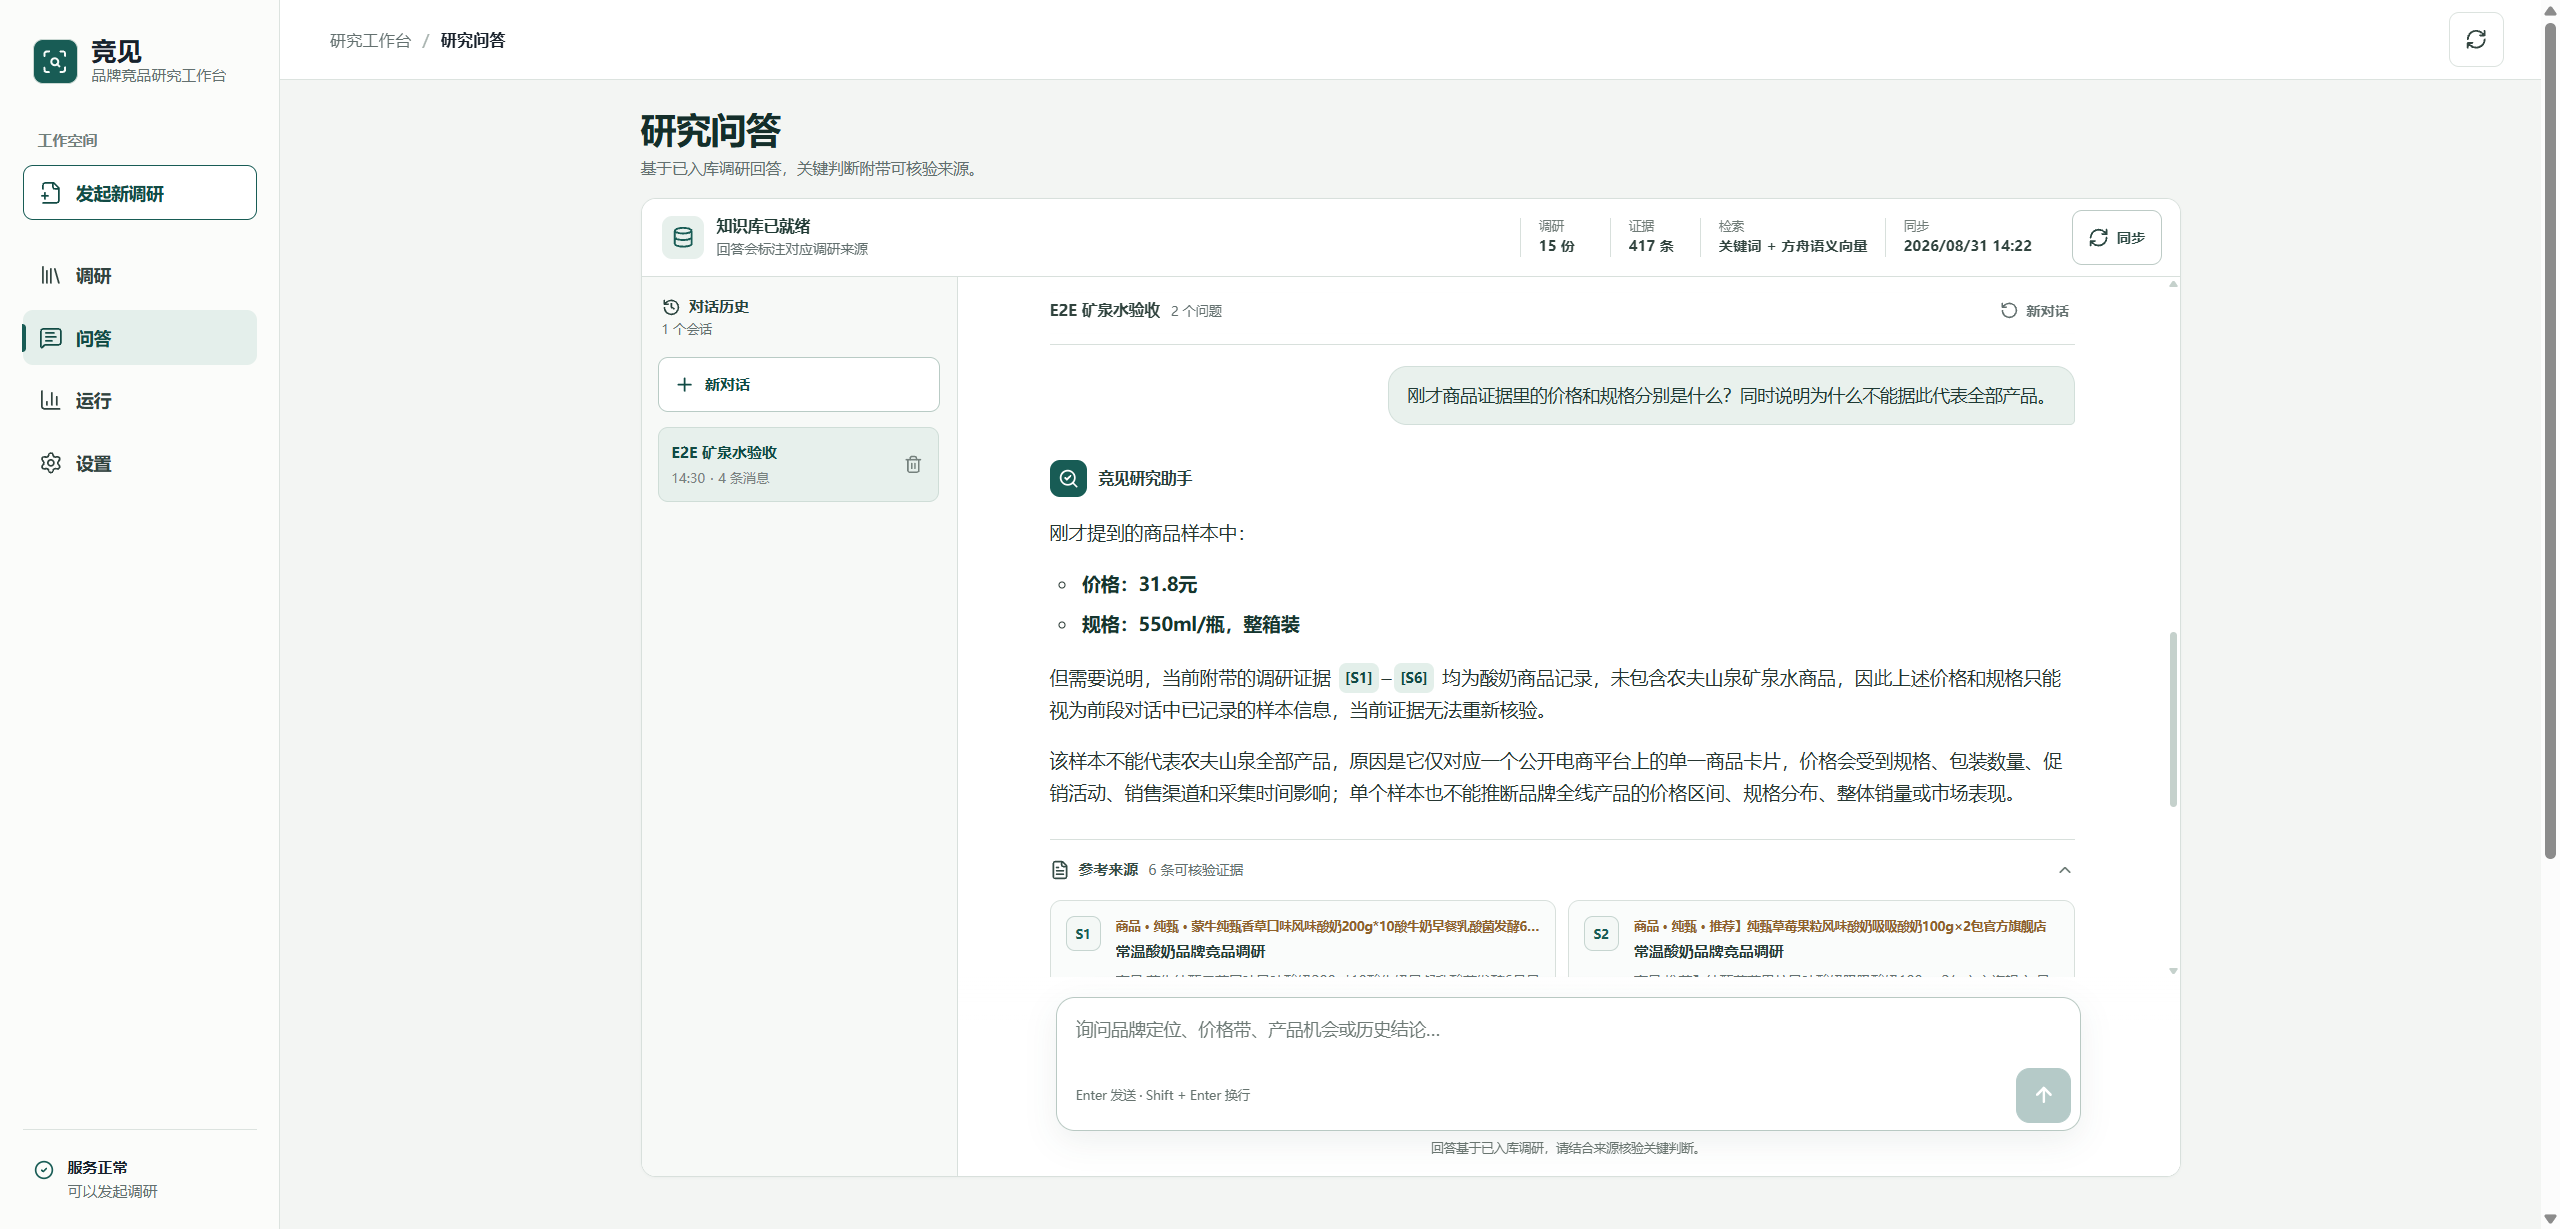
问答页同时显示已同步报告数、证据块数量、检索方式、回答引用和来源卡片。
连续追问怎样不跑题
会话、消息、部分流式回答、引用快照和滚动摘要都写入独立的会话库。系统组合最近对话、尚未归纳的衔接内容、与当前问题相关的较早问答和滚动摘要,而不是无限追加整段历史。
“那它的价格呢?”这类追问会继承上一轮问题和来源报告的范围;出现“换一个品牌”之类的明确转向时,则不再沿用旧范围。会话记忆只帮助理解指代,不能代替报告证据。
三层数据各管一件事
| 数据层 | 保存什么 | 为什么分开 |
|---|---|---|
| 研究主库 | 任务、请求、最终报告与校验值 | 是事实来源;任务完成与报告写入保持一致。 |
| 知识索引库 | 业务知识块、FTS5 文本和向量 | 可以从主库重建,索引失败不会破坏报告。 |
| 会话库 | 会话、消息状态、引用和摘要 | 保留断线前的部分结果,并支持安全重试。 |
前端用 React、TypeScript 和 TanStack Query 管理工作台状态;FastAPI 负责任务、流式事件和知识接口;共享 Chrome 配合 Python RPA worker 与 Playwright/CDP 完成淘宝页面采集和人工验证;HTML 分页内容再渲染为 PPTX。当前设计面向一台 Windows 工作站上的个人或小团队,不是多租户、分布式爬虫平台。
现在的边界
- 淘宝采集依赖有效登录态、可交互桌面和人工处理平台验证,页面结构或风控变化会影响成功率。
- 商品截图和价格是研究样本,不代表整个市场;报告结论仍要结合采集范围阅读。
- 使用外部向量模型时,待索引的知识块和查询文本会发送给对应服务;回答模型会收到召回证据和有限的会话上下文,因此并非所有处理都在本机完成。
- 引用校验确认的是“引用编号来自本轮证据”,不是逐句事实审计。
- 正式交付物是一份 PPTX;HTML 用于预览,知识索引用于继续查询。
项目代码见 linsk27/jingjian-taobao-agent。本文按最新开发分支 feat/sqlite-primary-storage @ fd30cd9 的实现整理。