我最近在看 NandhaKishorM/laya。它经常和 Jev 放在一起讨论,原因很简单:两者都不是用来聊天的,而是让模型回答一些程序能直接使用的问题。
比如收到一封邮件,程序真正关心的可能只有三件事:
- 应该交给账单组还是技术组?
- 用户有没有明确要求退款?
- 这件事要不要马上处理?
如果让普通大模型回答,通常要让它写一段话,再从话里解析 JSON。Laya 的做法是把问题和答案范围先写清楚,模型直接返回选项、分数和概率。后面的分流、审核、调用哪个模型,仍由你的代码负责。
本文根据 Laya 仓库 42626c3 提交整理,包版本为 0.3.4。没有在本机下载权重,也没有把仓库里的 Jev 跑分当成同条件实测。
先跑一个小例子
Laya 的调用始终围绕两个东西:要判断的 state,以及问题 questions。
| |
choice 是从几个选项里选一个,noul 是判断一个命题为真的概率,另外还有按等级评分的 score。一批问题可以一起提交,但它们互相看不到答案;如果第二个问题依赖第一个结果,就由业务代码再发起下一步。
这里有个容易误会的地方:score 的结果是等级索引的加权平均,不是测量出来的真实数值。比如三个等级的概率是 [0.1, 0.3, 0.6],分数是 1.5,它只能说明结果更靠近高等级,不能直接解释成“75% 紧急”或“还剩几小时”。
它在模型里做了什么
Laya 的核心代码在 laya/agent.py 和 laya/common.py。
调用时,程序会把问题说明、候选答案和 state 拼成一条输入。每个候选答案前面留一个标记,双向 Transformer 读完整条序列后,scorer 只在这些标记位置上打分。最后再把分数转成概率。
大致可以画成:
| |
它不生成自然语言,所以没有“生成一段 JSON,再尝试解析”的步骤。这样确实让接口更稳定,但不代表判断就一定正确。它仍然可能把一封退款邮件分到技术组,只是返回的格式不会突然变成一段解释文字。
一次调用不等于只算一次正文
代码会为每个问题各自拼一条序列,然后把这些序列组成 batch,一次送进模型。
所以,同一封邮件问十个问题,并不是“正文只编码一次,十个问题免费复用”;实际是十条输入一起算,只是批处理比十次完全独立调用更高效。仓库在 T4 上测到多语言模型单问题约 32.8ms,十个问题约 72.3ms。这个数字是作者的测试环境,不能直接当成你电脑上的保证。
Router 到底路由什么
Laya 里有两个容易混淆的名字:
- Router:在 Laya 自己的几个 checkpoint 之间选择;
- router_questions():一组“请求属于什么领域、难度如何”的问题模板。
Router 不会替你选择 GPT、Claude 或 Codex。它现在主要在三个 checkpoint 之间选:
- laya:英语,ModernBERT-large;
- laya-multilingual:多语言,mmBERT-base;
- laya-typed-decisions:针对四类业务流程微调的版本。
它的语言判断不是再调用一个模型。laya/lang.py 会统计 Unicode 字符,先判断文字系统;如果是拉丁文字,再用停用词和变音符号猜测部分语言。检测到中文、日文、阿拉伯文等,就会倾向多语言 checkpoint。
这一步很有必要。仓库的测试里,英文模型遇到非英语文字时可能“很自信地答错”,所以不能等模型输出一个低置信度再补救,应该先决定用哪个模型。
默认的 Router() 还会懒加载模型,并用 LRU 控制内存。如果中英文请求交替到来,模型可能反复卸载和加载;服务端通常应该预加载需要的 checkpoint。typed-decisions 也不是默认自动选择的,除非你显式指定,或者开启代码里那几个固定问题 ID 的识别。
confidence 不是“正确率”
Laya 的 choice 和 score 会返回 probabilities 和 confidence。代码里的 confidence 是根据概率分布的熵算出来的:概率越集中,数值越高;几个选项差不多,数值越低。
它不是最高选项的概率,也不是“这次答对的概率”。二选一给出 [0.9, 0.1] 时,按 Laya 的公式,confidence 约为 0.53,不会直接返回 0.9。noul 又是另一种形式,直接返回“为真”的概率。
因此,不能把所有问题都套一个 0.85 阈值。退款、删数据、改权限这类操作,应该用自己的验证集确定门槛,低置信度进入人工或大模型复核。仓库也明确提到基础模型存在过度自信,需要重新做 temperature calibration。
另外,代码里有个 act_head,会返回 act_probability。当前实现只是把这个值放在结果里,并没有替你执行动作,也不能因为字段名字像“是否行动”就把它当成生产开关。
Laya 和 Jev,区别不只是“一个开源一个闭源”
两者的接口思路很像:给 state 和 questions,支持 choice、score、noul,一次请求回答多个问题。这也是它们经常被放在一起比较的原因。
但使用时差别很明显:
| 项目 | Laya | Jev |
|---|---|---|
| 运行方式 | 下载 Hugging Face 权重,本地 Python/PyTorch 推理 | 调用 TypeSafe 托管 API |
| 能否看实现 | 编码器、打分头、训练 notebook 都在仓库里 | 官方没有公开可逐层核对的模型实现 |
| 适配业务 | 改问题,也可以自己微调 checkpoint | 主要通过 state、instructions、criteria 适配,官方不提供客户级 LoRA |
| 上下文 | 常见配置为 512 或 1024 token,问题和正文共用预算 | 官方文档给出 64k 请求上限,state 还有单独限制 |
| Choice 选项 | 默认选项预算较紧,仓库建议控制在约 20 个以内 | API 最多 255 个选项 |
| 运维 | 自己负责权重、显存、并发、冷启动 | 不维护模型,但要处理 API key、网络、限流和版本 |
| 成本 | 自托管没有调用费,但要承担机器成本 | 按输入 token 计费,输出 token 不单独计费 |
Jev 的具体上限和接口可以看 官方 Models 文档 与 API 文档。Laya 的限制主要来自 build_sequence():它会先给问题和候选项分配一段固定预算,剩下的才给正文。选项太多时,每个标签被压缩得很短,分类自然容易掉点。
Jev 的上下文更长,但也不是万能的。官方已经列出它在算术、日期比较、多步间接推理、无关长文本和对抗性内容上的问题。两者都有一个共同原则:能用代码准确算的事情,就不要交给模型。
跑分应该怎样看
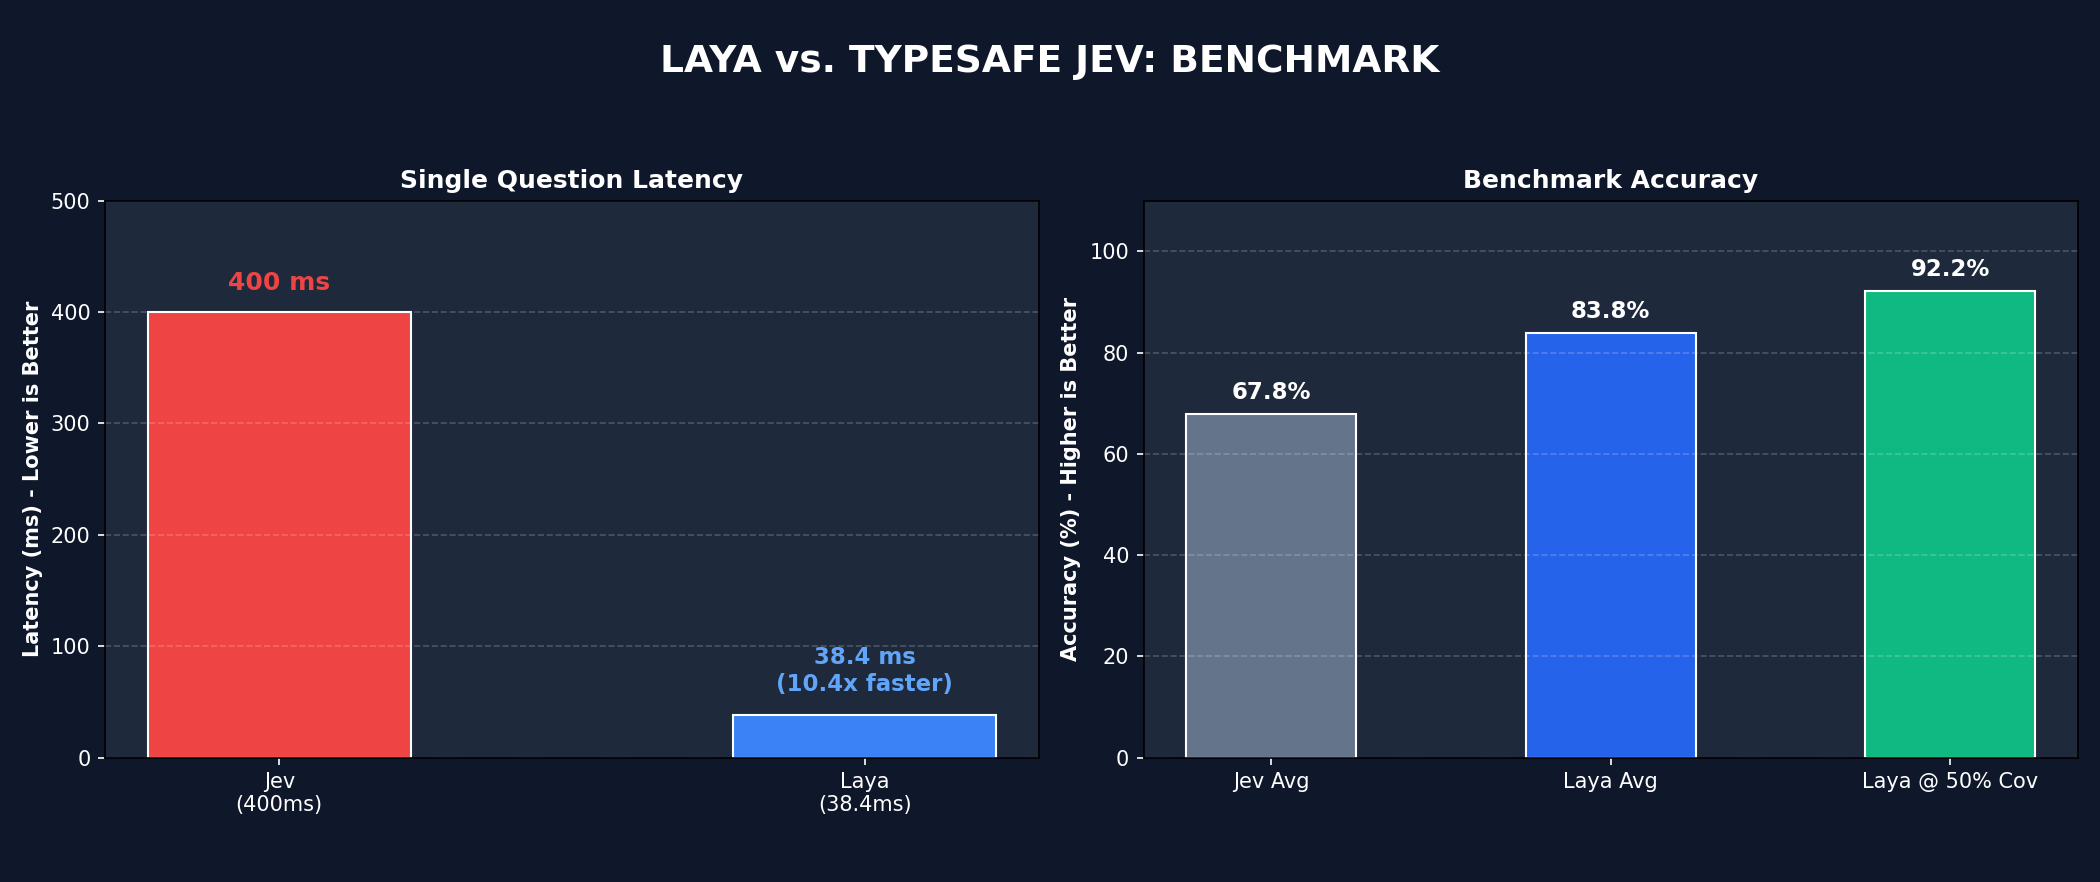
Laya 仓库里有和 Jev 的对比表,但研究说明也写了限制:Jev 的数字来自第三方公开结果,Laya 没有在同一环境调用 Jev,因此不是严格的 A/B 测试。
还有两个容易被忽略的细节:
第一,typed-decisions 的 0.766 来自专门微调过的 laya-typed-decisions,不是默认基础模型的零样本成绩。仓库里基础模型在这组任务上只有约 0.34,低于多数类基线。
第二,准确率和概率质量不是一回事。Laya 微调版在某组测试中的最终选项准确率高于 Jev 引用值,但软分布匹配反而更低。要拿概率做自动放行,就不能只看“选中了谁”,还要看概率是否经过校准。
所以,文章里可以说“Laya 在部分公开任务上有竞争力”,不能简单写成“全面超过 Jev”。
它适合放在什么位置
我觉得最实际的接法有三种:
- 入口分流:先把请求分成账单、技术、销售,再交给对应流程。
- RAG 过滤:检索拿到候选段落后,先判断哪些段落真的相关,再送给生成模型。向量库、引用和最终回答仍由你的系统负责。
- Agent 闸门:判断是否需要工具、是否有风险、是否必须人工确认。
如果想用它来节省 token,关键不是“让 Laya 替代大模型”,而是让一些请求根本不用走最贵的路径。前提是 Laya 本地运行足够便宜,而且路由结果能改变后续流程。每次请求都先远程调用一次 Laya,再调用大模型,收益可能就不明显了。
和 Codex 配合也一样:Codex 可以帮你写接入代码,但 Laya 不会自动接管 Codex 的内部模型选择。你需要自己提供 Python 服务、HTTP 接口或 MCP 工具,把 Laya 的结果交给调度层。
最后怎么评价它
Laya 更像一个可以自己部署、自己微调的判断模型底座,不是完整的 Agent 平台,也不是 GPT 的替代品。它最适合固定问题、有限选项、请求量较大,而且你愿意准备数据和验证集的场景。
Jev 更像开箱即用的托管服务:不用管权重和显存,输入空间也更宽,但结果依赖远程 API,模型版本和成本由服务方控制。
如果只是想试一下 System One 这种“只返回判断、不生成文字”的思路,Laya 很适合读源码。真正接入生产环境前,我会先拿自己的请求测试三件事:截断会不会影响结果、低置信度能不能真的筛出风险、模型冷启动和常驻内存是否能接受。
先把一个具体判断测清楚,再决定要不要把它放进整套 Agent。